글

라벨이 Pose Estimation인 게시물 표시

Realtime multi-person 2d pose estimation using part affinity fields (CVPR 2017)
이미지
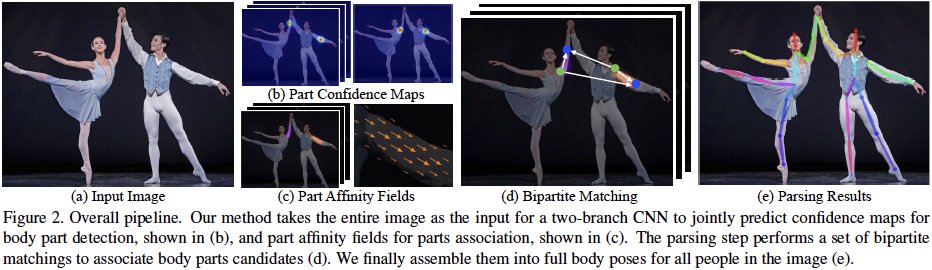
논문 제목: Realtime multi-person 2d pose estimation using part affinity fields 연구 기관: Carnegie Mellon University 본 리뷰 글은 CMU 에서 발표한 pose estimation 논문 시리즈 중 마지막 리뷰 글이다 (물론 본 글 게재 이 후에도 CMU 는 새로운 pose estimation 논문을 계속 발표하겠지만...). 두 개의 선행 연구 논문은 아래와 같으며, 여기를 클릭하면 ( Pose Machine , Convolutional Pose Machine ) 리뷰 글을 볼 수 있다. 선행 연구 논문 Ramakrishna, V., Munoz, D., Hebert, M., Bagnell, J. A., & Sheikh, Y. (2014, September). Pose machines: Articulated pose estimation via inference machines. In European Conference on Computer Vision (pp. 33-47). Springer, Cham. Wei, S. E., Ramakrishna, V., Kanade, T., & Sheikh, Y. (2016). Convolutional pose machines. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (pp. 4724-4732). 본 연구 역시 선행 연구들에서 채택하였던 cascaded stage architecture 를 그대로 유지하고 있다. 다만, feature extraction 및 belief map 을 생성하는 CNN 구조를 조금 바꾸고, 'part affinity field' 라는 새로운 개념을 도입하여, part 사이의 상관 관계를 보다 명시적으로 (explicitly) 네트워크에 반영하였다 (이전...

Convolutional pose machines (CVPR 2016)

이미지
논문 제목: Convolutional pose machines 연구 기관: Carnegie Mellon University 본 연구는 아래 선행 연구의 후속 연구로써, 선행 연구의 전체 적인 기술 구조는 유사하게 적용하면서 선행 연구 기술 구조 내의 'hand-crafted' function 을 'neural network' function 으로 대체한 것이다. 이해를 돕기 위해, 본 리뷰를 보기 전에 선행 연구에 대한 간단한 리뷰를 먼저 보기를 권장한다. 선행 연구에 대한 리뷰 글은 여기를 클릭하면 볼 수 있다. 선행 연구 논문 Ramakrishna, V., Munoz, D., Hebert, M., Bagnell, J. A., & Sheikh, Y. (2014, September). Pose machines: Articulated pose estimation via inference machines. In European Conference on Computer Vision (pp. 33-47). Springer, Cham. 용어 정의 Stage 선행 연구와 유사하게 동일한 처리 블럭을 순차적으로 연결한 구조를 뜻한다. Part 추정하고자 하는 사람의 관절 P (p: 1 ~ P) 전체 part 개수 Belief map 이미지 내 각 픽셀이 part 위치일 확률 (입력 이미지 크기와 동일 크기의 map) 각 part 마다 1장 씩 할당 각 ground truth part position 을 정점으로 하는 gaussian 형태의 확률 분포  아래 그림 (a) 에서의 b t  또는 아래 그림 (c) 에서  h'  x  w'  x  (P+1) 선행 연구에서는 'confidence map' 이라고 표현하였음 Image patch 전체 이미지 중 특정 location z 픽셀 주위의 일정 영역 (local im...

Pose machines: Articulated pose estimation via inference machines (ECCV 2014)

이미지
논문 제목: Pose machines: Articulated pose estimation via inference machines 연구 기관: Carnegie Mellon University 본 연구는 multi-stage classifier 를 이용하여 human pose 를 추정하는 기술에 관한 것이다. 본 연구는 neural network 기반의 기술이 아니라 hand-crafted feature function 을 적용 하였다. 아래 본 연구의 후속 연구에서 유사한 전체 기술 구조에 기반하여 hand-crafted function 을 neural network 로 대체한 기술을 발표하였다. 따라서 본 연구는 기술의 key idea 에 대해 간단히 설명하고, 자세한 내용은 조만간 게재할 후속 연구 리뷰 글에서 기술하기로 한다. 후속 연구 논문 Wei, S. E., Ramakrishna, V., Kanade, T., & Sheikh, Y. (2016). Convolutional pose machines. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (pp. 4724-4732). 본 연구에서 제안하는 전체적인 기술 구조는 아래 그림과 같으며, 연구자들은 'Pose Machine' 이라고 명명하였다.  <Pose Machine Architecture> 이해를 돕기 위해, 용어 정의 부터 설명한다. Part 추정하고자 하는 사람의 관절 P (p: 1 ~ P) 전체 part 개수 Confidence map 이미지 내 각 픽셀이 part 위치일 확률 (입력 이미지 크기와 동일 크기의 map) 각 part 마다 1장 씩 할당  (위 그림에서 파란색 그림에 해당) Image patch 전체 이미지 중 특정 location z 픽셀 주위의 일정 영역 ...

Towards Accurate Multi-person Pose Estimation in the Wild (CVPR 2017)

이미지
논문 제목: Towards Accurate Multi-person Pose Estimation in the Wild 연구 기관: 구글 본 연구는 Faster R-CNN 으로 사람 영역의 rectangular bounding box 를 찾고, box 영역 내에서 pose estimation 을 처리하는 2단계 기술 구조를 제안한다 (아래 그림 참조). [ Network Architecture ] Person detection 을 위한 faster R-CNN 은 ResNet101 을 backbone 으로 사용하였다. Person detection 에 의해 검출된 영역은 가로 또는 세로 길이를 변환하여 가로/세로 비율이 일정 비율을 가지도록 하였다  (위 그림 (1) 의 person detection 결과인 붉은 색 box 가 (2) 에서는 세로 방향으로 축소된 모습을 볼 수 있다) . 학습 시의 데이터 증강을 위해 person detection 결과 box 영역을 1.0 ~ 1.5 사이의 scale factor 값을 무작위 선정하여 조금 더 넓은 person box 를 학습 데이터로 추가하였다. 추론 시에는   scale factor 값을 1.25로 고정시켰다. 이와 같은 image cropping 및 re-sizing 을 통해 최종적으로 353 x 257 크기의 이미지를 생성하여 pose estimation module 로 전달한다. 또한, activation feature point 의 이미지 분석 대상 영역을 넓히기 위해서 atrouse convolution 을 적용하였다. Atrouse convolution 은 convolution kernel 의 분석 포인트를 일정 간격을 두고 배치한 kernel 이다. 아래 그림에서 (a) 가 일반적인 convolution kernel 이고, (b) 와 (c) 그림이 각각 convolution point 를 일정 간격을 두고 convolution poi...